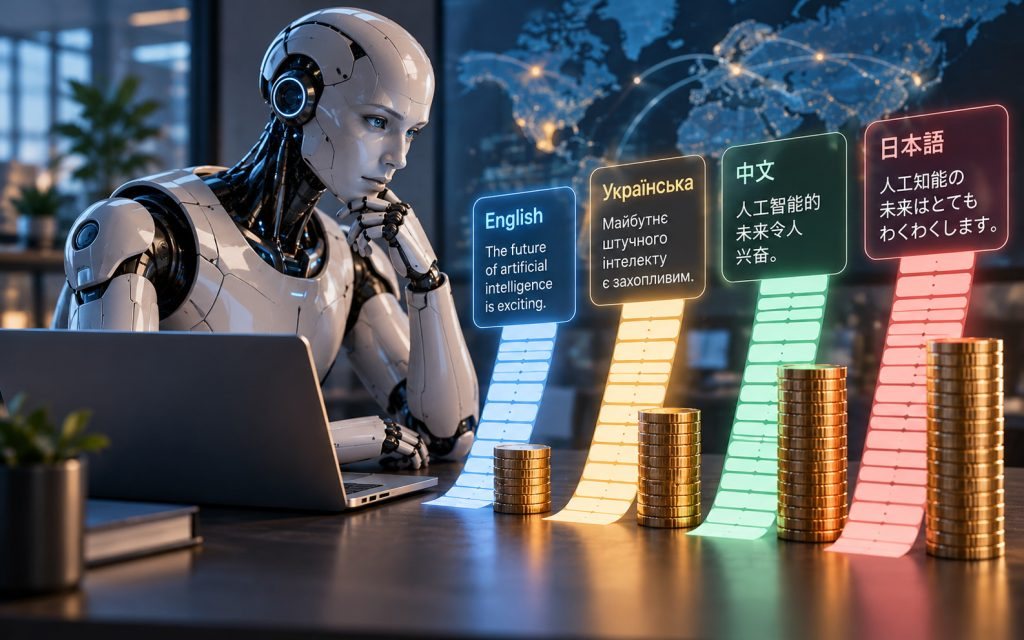
Використання штучного інтелекту мовами, відмінними від англійської, може коштувати більше. Причина полягає в особливостях токенізації тексту: для обробки однакового за змістом повідомлення одним мовам потрібно значно більше токенів, ніж іншим. За даними дослідження, на яке звернуло увагу видання Rest of World, різниця в найширшому порівнянні сягнула 17 разів.
Дослідники з Coalition for Language Equity in AI Research назвали це явище tokenizer tax, або прихованим податком на використання ШІ певними мовами. Проблема може впливати не лише на вартість запитів до моделей, а й на швидкість відповідей та обсяг інформації, яку модель здатна врахувати в межах одного контексту.
Токен є одиницею тексту, на які мовна модель розбиває вхідні дані. Залежно від токенізатора це може бути ціле слово, його частина, окремі символи або їхні комбінації. У багатьох комерційних сервісів вартість обробки залежить від кількості вхідних і вихідних токенів. Якщо токенізатор неефективно працює з певною мовою, той самий зміст розбивається на більшу кількість одиниць, і користувач платить більше за запит і відповідь, навіть виконуючи те саме завдання.
За результатами дослідження, серед 20 найпоширеніших мов інтернету різниця між мовами з найменшою та найбільшою кількістю токенів становила від 1,5 до п’яти разів. Коли дослідники розширили вибірку до 200 мов, в одній із моделей розрив зріс до 17 разів. Кількість носіїв мови та обсяг доступних в інтернеті текстів не є єдиними чинниками. Велике значення має система письма, з якою працює токенізатор.
Найбільші труднощі в більшості проаналізованих моделей виникали з мовами, писемність яких недостатньо представлена в даних токенізаторів. Серед них названо бірманську, тибетську, кхмерську, лаоську, а також мови, що використовують письмо тифінаг і ол-чікі. Дослідники навели й протилежний приклад: астурійська мова має відносно невелику кількість носіїв і не представлена в Common Crawl, великому корпусі вебданих, проте отримує перевагу завдяки латинській абетці та схожості з іншими романськими мовами, зокрема італійською. Це свідчить, що ефективність токенізації залежить не лише від обсягу навчальних даних, а й від того, наскільки токенізатор пристосований до письма та мовних особливостей конкретної мови.
Наслідки не обмежуються зростанням витрат на API. Чим більше токенів потрібно для обробки тексту, тим більше обчислень може знадобитися моделі, що потенційно збільшує затримку під час генерації відповіді. Крім того, за однакового ліміту контексту модель може врахувати менше тексту, історії розмови чи додаткових документів, якщо вони токенізуються менш ефективно. Це особливо важливо для сервісів, які працюють із великими обсягами інформації або зберігають історію взаємодії з користувачем.
Співзасновник Activate AI Пратюш Чоудхурі пояснив Rest of World, що така проблема може впливати, зокрема, на якість AI-репетиторів. Якщо історія помилок учня та попередніх пояснень займає більшу частину доступного контексту, сервісу стає складніше враховувати попередню взаємодію. Для компаній, які розробляють AI-продукти для різних ринків, це також створює економічну нерівність: вартість обслуговування користувачів може відрізнятися залежно від мови, навіть якщо вони отримують однакові функції.
Одним зі шляхів зменшити різницю є вдосконалення токенізаторів, щоб вони ефективніше працювали з мовами та системами письма, які наразі представлені недостатньо. Самого збільшення обсягу навчальних даних може бути замало, тому розробникам потрібно враховувати особливості токенізації вже під час проєктування моделей. Генеральний директор Maya Research Дімант Редді зазначив, що ціни на токени швидко знижуються, тож прямий вплив проблеми на витрати з часом може зменшитися. Втім, це не усуває потреби вдосконалювати токенізатори.
Співзасновник Activate AI пропонує великим AI-компаніям публікувати окремі показники ефективності для різних мов. Такі звіти могли б показувати, скільки токенів і коштів потрібно для виконання зіставних завдань, а також допомагати відстежувати прогрес у підтримці мов, які наразі перебувають у невигідному становищі. Отже, розвиток багатомовного ШІ залежить не лише від здатності моделей розуміти різні мови, а й від того, наскільки ефективно вони обробляють текст кожною з них, адже це впливає на витрати, швидкість роботи та доступний контекст.
2