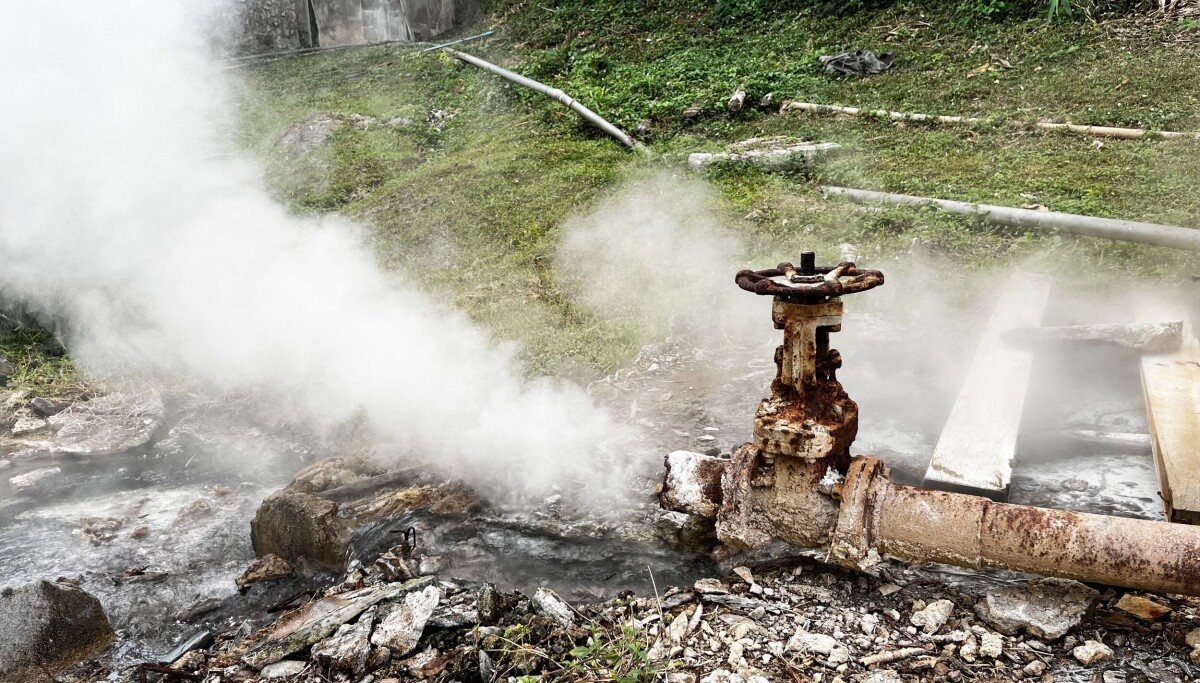
Модель штучного інтелекту за чотири години виявила чотири серйозні вразливості в програмному забезпеченні, яке використовується для керування промисловими об’єктами. Швидкість, з якою система впоралася із завданням, викликає і захоплення, і занепокоєння фахівців, адже йдеться про програмне забезпечення, від якого залежить робота виробництва.
Програмне забезпечення є критично важливим для функціонування багатьох виробничих процесів, енергетичних систем та іншої інфраструктури. Традиційно пошук подібних слабких місць потребує значних ресурсів, часу та експертизи фахівців з кібербезпеки. Тому здатність AI-системи зробити це за такий короткий термін свідчить про її потенціал у сфері виявлення загроз.
Виявлені вразливості, за оцінкою джерел, могли б призвести до серйозних наслідків. Серед них названо можливе порушення роботи промислових процесів, витік конфіденційної інформації та навіть фізичні пошкодження обладнання. Саме тому, як підкреслюють автори матеріалу, важливо постійно вдосконалювати механізми захисту таких систем.
Процес тестування на проникнення та пошуку вразливостей у промисловому програмному забезпеченні зазвичай є багатоетапним і тривалим. Він включає аналіз коду, моделювання атак і перевірку безпеки мережевої інфраструктури. Системи штучного інтелекту, які обробляють великі обсяги даних і виявляють складні закономірності, здатні значно прискорити кожен із цих етапів.
Водночас результати роботи моделі потребують подальшої верифікації з боку людини. Експерти з кібербезпеки мають підтвердити природу виявлених вразливостей і оцінити їхню реальну небезпеку, адже швидкий результат ще не означає, що всі знахідки є підтвердженими загрозами. Дослідження такого роду спрямовані не лише на пошук наявних проблем, а й на стимулювання розробників до створення безпечнішого програмного забезпечення.
Цей випадок вписується в ширшу тенденцію. За даними Remote Labor Index, який перевіряє здатність ШІ довести до кінця повноцінні фріланс-проєкти, автоматизація цифрової праці поступово виходить за межі навчальних завдань. Коли бенчмарк запускали, найкраща система автоматизувала 2,5% проєктів. За даними Center for AI Safety, станом на липневе оновлення 2026 року модель Fable 5 досягла близько 16%, Opus 4.8 близько 8%, а GPT-5.5 близько 6%.
Ці цифри варто сприймати з застереженнями. Оцінювання Fable 5 перервали через експортні обмеження США, тому перевірили лише 218 із 240 проєктів. Навіть якщо вважати всі неоцінені проєкти провалленими, показник залишається на рівні 14,6%. Автори аналізу наголошують, що головний висновок полягає не в тому, що людей замінять, а в тому, що автоматизація реальної фріланс-роботи піднялася з майже нульового рівня до позначки, яку бізнес уже не може ігнорувати.
Швидкість, з якою ШІ може виявляти недоліки, дозволяє оперативно усувати їх до того, як ними скористаються зловмисники. Але, як зазначають аналітики, ефективність таких систем варто оцінювати не лише за швидкістю, а й за точністю та тим, наскільки їхні висновки можна перевірити.
5